Swapstracker: un binario, 3.100 millones de trades, una placa pequeña
Cómo llevé Swapstracker de una estimación de un año con mi primera versión en TypeScript a una sincronización de 20 días con una reescritura en Go y TimescaleDB en una Radxa ROCK 5C.
Ambas versiones son código propietario mío. Este texto describe el diseño solo a alto nivel.
Qué hace
Swapstracker sigue el trading en DEX de cadenas EVM. Lee eventos de swap de pools estilo Uniswap V2, V3 y V4,
calcula el precio en USD de cada trade y sirve trades, estadísticas de pares y velas OHLCV mediante una API. Los
trades nuevos llegan en vivo a un frontend SvelteKit.
Este texto cubre dos cadenas, Ethereum y BSC, con dos años de histórico.
La plataforma admite más cadenas EVM. Todas las cifras de esta página se refieren solo a Ethereum y BSC.
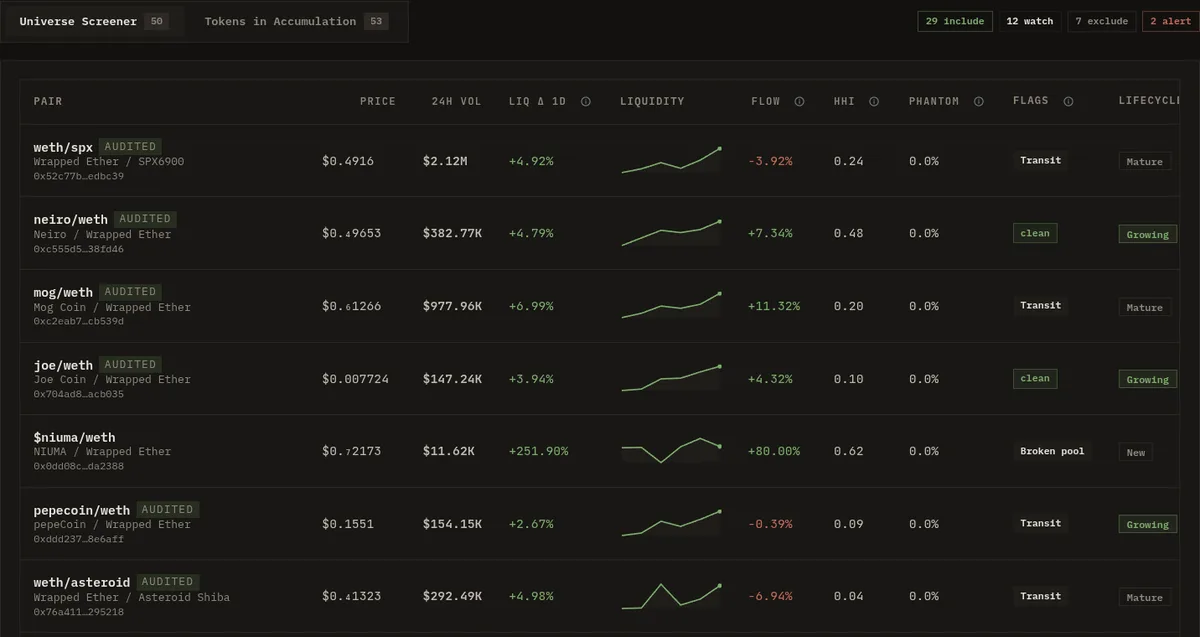
En qué se convierten los trades indexados: un screener con liquidez, flujo de órdenes y concentración de holders por par.
Dónde se iba el tiempo
Escribí la primera versión de Swapstracker como un conjunto de microservicios TypeScript que escribían en MongoDB. Cada servicio tenía
sentido por separado. Juntos gastaban buena parte de la CPU y la memoria convirtiendo objetos en mensajes y
mensajes otra vez en objetos, solo para pasar los datos al siguiente servicio.
Mido el avance en bloques por segundo, registrados de forma continua. Al ritmo que sostenía mi primera versión,
los logs proyectaban alrededor de un año para sincronizar dos años de ambas cadenas. Esa cifra es una proyección:
no dejé correr la primera versión un año para confirmarla.
Qué cambié
Un binario para el recorrido de logs a trades. Extracción, resolución de pares, timestamps,
precios y persistencia pasaron a ser etapas de un único proceso Go, que se pasan structs en memoria.
Menos fronteras, menos transformaciones. Al quitar los saltos entre servicios desapareció la
serialización y el parseo que venía con cada uno.
PostgreSQL con TimescaleDB en lugar de MongoDB. Los trades son series temporales. Hypertables,
compresión y continuous aggregates encajan con esa forma.
La medición siguió encendida. Los bloques por segundo se quedaron en logs y métricas, así que
cada cambio se veía como un número.
No es un resultado de Go contra TypeScript. Cambiaron a la vez la arquitectura, el acceso a datos y el
almacenamiento.
Mi primera versión
Indexador actual
Simplificado. Lo importante no es el número exacto de servicios, sino los saltos.
El indexador es un proceso; la plataforma no. La API, Redis, la base de datos y el frontend corren como servicios
propios.
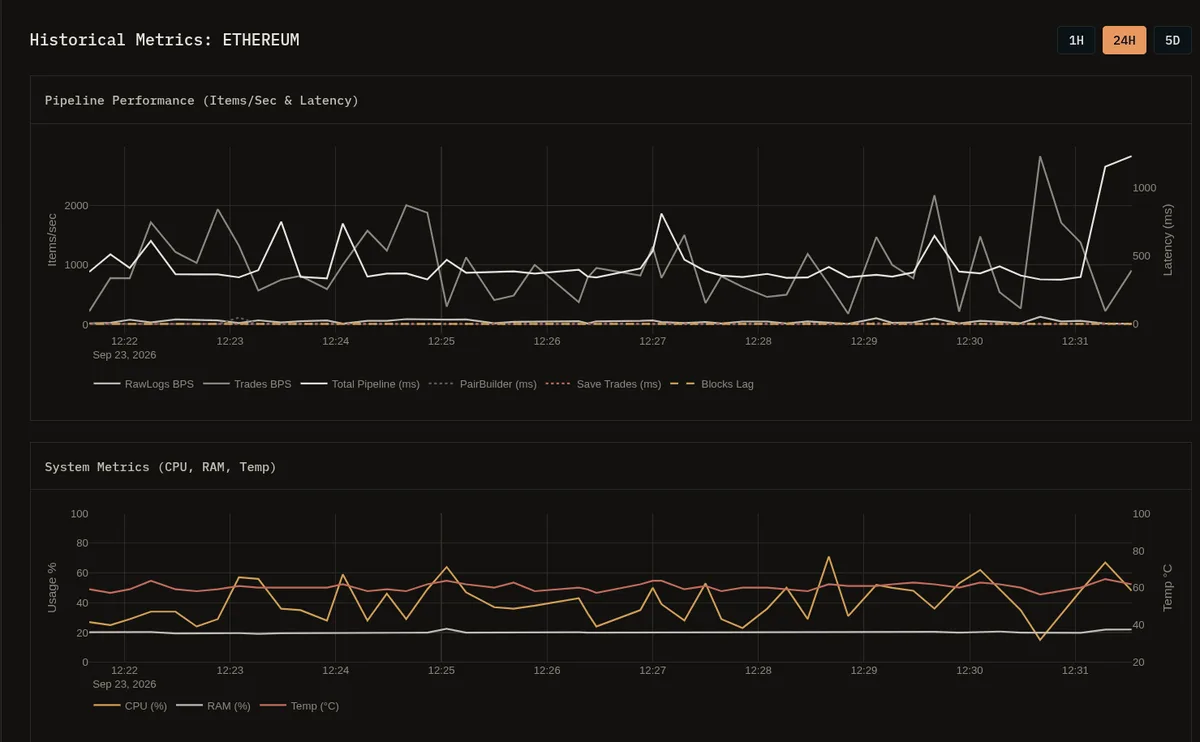
El indexador reporta su propio ritmo, latencias por etapa, retraso de bloques, CPU, RAM y temperatura. Diez minutos de indexación en vivo de Ethereum el 23 de septiembre de 2026; una vista de monitoreo, no un benchmark.
En paralelo, pero en orden de bloques
Dentro del indexador, un asignador reparte rangos de bloques consecutivos, con el tamaño que decide el optimizador
de lotes. Varios workers toman rangos a la vez. Cada uno descarga sus logs y después resuelve en paralelo los
metadatos de los pares y los timestamps de los bloques, mirando la caché local antes de preguntar a la red.
Los workers terminan en el orden que permite la red, así que sus lotes pasan por un buffer de reordenamiento. Un
único committer calcula precios y los escribe estrictamente en orden de bloques, de modo que el histórico crece
sin huecos aunque la extracción corra en paralelo.
Un número fijo de lotes en vuelo limita cuántos lotes preparados pueden esperar a la vez. Si un rango va lento,
los demás workers dejan de tomar trabajo nuevo en lugar de llenar la memoria.
El número de workers se ajusta en ejecución. El orden no depende de él: solo el committer escribe.
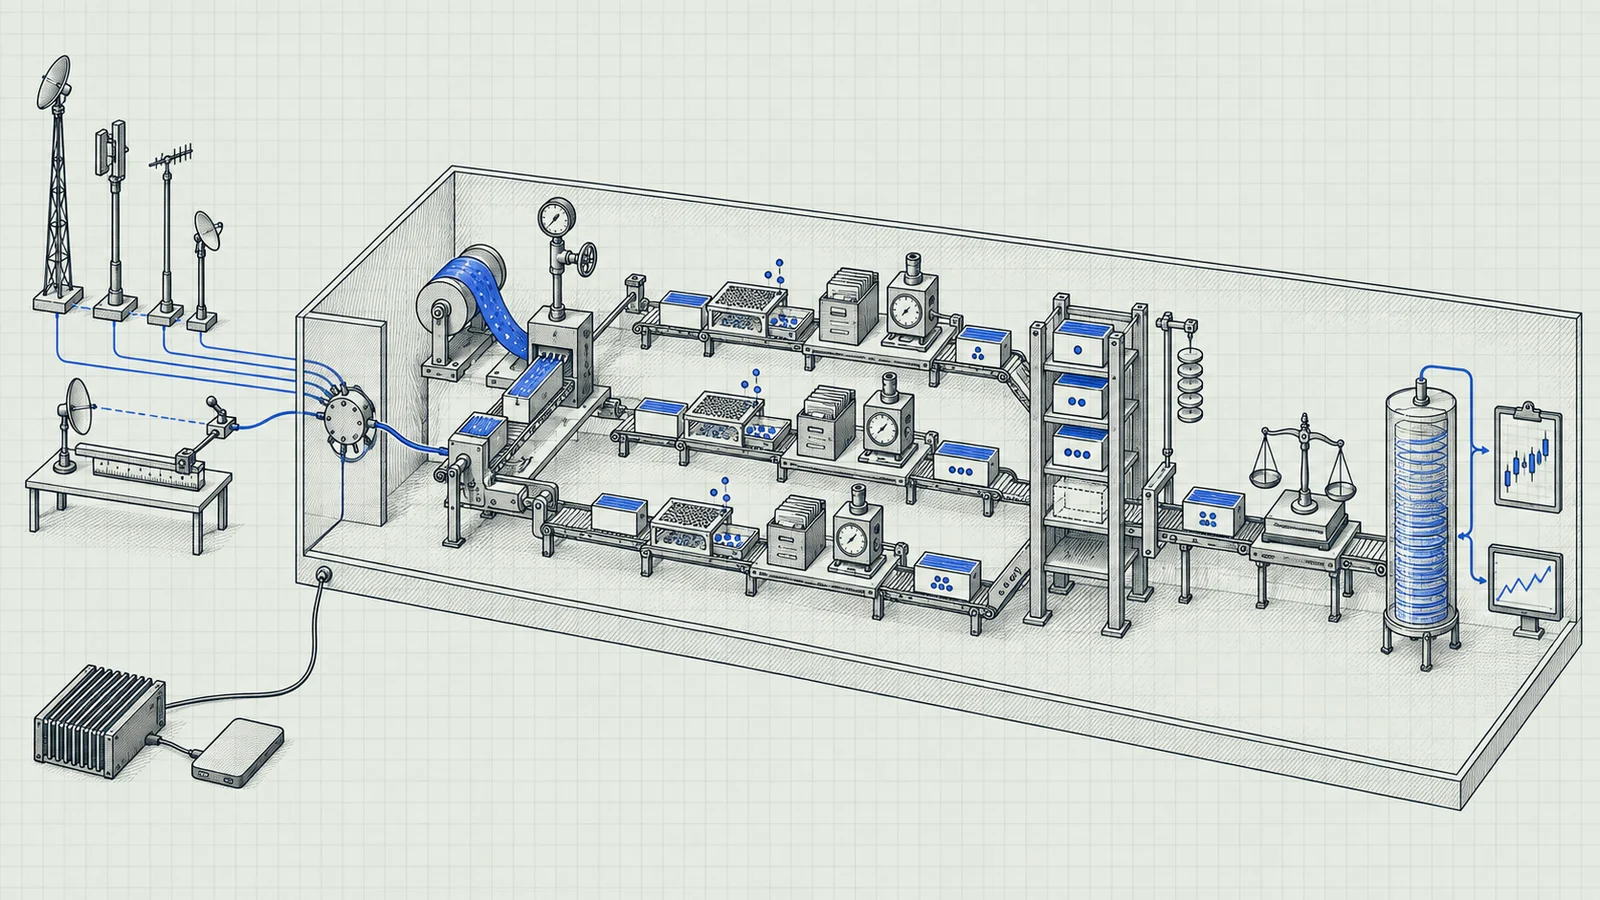
1234567
Proveedores RPC, validados contra baselines, con failover entre ellos
El tamaño del lote se adapta a la salud del proveedor y a la densidad de logs
Workers en paralelo extraen logs, resuelven pares y asignan timestamps
Buffer de reordenamiento: los lotes terminados esperan su turno
Un único committer calcula precios en memoria y escribe en orden de bloques
TimescaleDB, que alimenta las velas y los trades en vivo
La Radxa ROCK 5C y el Samsung T7 que lo ejecutan
Una ilustración del diseño, hecha con un modelo de imágenes a partir de mi descripción del indexador. No es una captura.
Resultados
Con esos cambios, la sincronización de dos años de ambas cadenas terminó en 20 días. El histórico guarda ahora
más de 3.100 millones de trades en cerca de 1 TB comprimido, y el indexador usa alrededor de un 80% menos de RAM
que mi primera versión.
También vi bajar la temperatura de la CPU unos 15 °C. La temperatura depende de la carga y del ambiente, así que
la dejo como observación, no como resultado.
Registro de mediciones
más de 3.100 millones
de trades guardados, dos años de Ethereum y BSC
observado
1 TB
de histórico comprimido, en un SSD de 2 TB
observado
20 días
para sincronizar esos dos años, ambas cadenas juntas
observado
≈ 1 año
lo que proyectaba mi primera versión para el mismo trabajo
estimación a partir de bloques/s registrados
80% menos
RAM después de la reescritura
reportado, aún sin benchmark reproducible
Una estimación frente a una observación, no un benchmark controlado. Cambiaron a la vez la arquitectura, el acceso a datos y el almacenamiento, así que el mérito no es de un solo factor.
La máquina
Todo esto corre en una computadora de placa única Radxa ROCK 5C con un SSD Samsung T7 de 2 TB conectado por USB.
El histórico comprimido ocupa cerca de la mitad de ese disco. La misma placa sirve también HabitsFlow y
GroupBrain, y las tres apps llegan a internet mediante Cloudflare Tunnel.
La placa no ejecuta nodos EVM completos. Los datos de las cadenas vienen de proveedores RPC; el trabajo del
indexador es sacar el máximo de cada petición y hacer el resto en local.
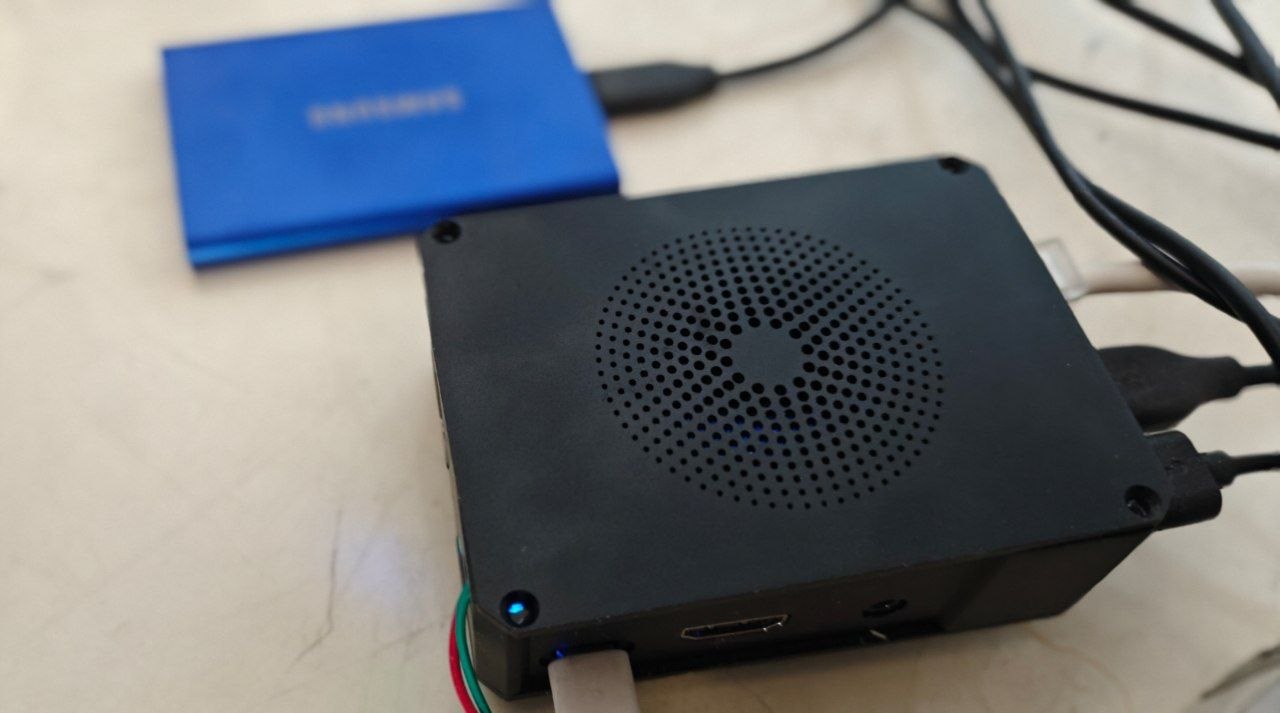
Samsung T7, 2 TBRadxa ROCK 5C
Radxa ROCK 5C, Samsung T7, 2 TB. Ejecuta Swapstracker, HabitsFlow y GroupBrain, publicados en internet mediante Cloudflare Tunnel.
Velas y trades en vivo
Velas. Continuous aggregates de TimescaleDB, un conjunto por cadena, mantienen el OHLCV
agregado de antemano, así que las consultas de gráficos leen resúmenes en lugar de recorrer trades crudos.
Lecturas concurrentes. Las peticiones idénticas que llegan a la vez comparten una sola consulta
a la base de datos mediante singleflight de Go. Agrupa lecturas en curso; no deduplica trades
guardados.
Trades en vivo. Los trades nuevos salen por Redis Pub/Sub y se reparten a los clientes
WebSocket, así que el frontend no hace polling.
Digo que la latencia OHLCV es baja. Aún no he publicado un p95, así que aquí no hay cifra en milisegundos.
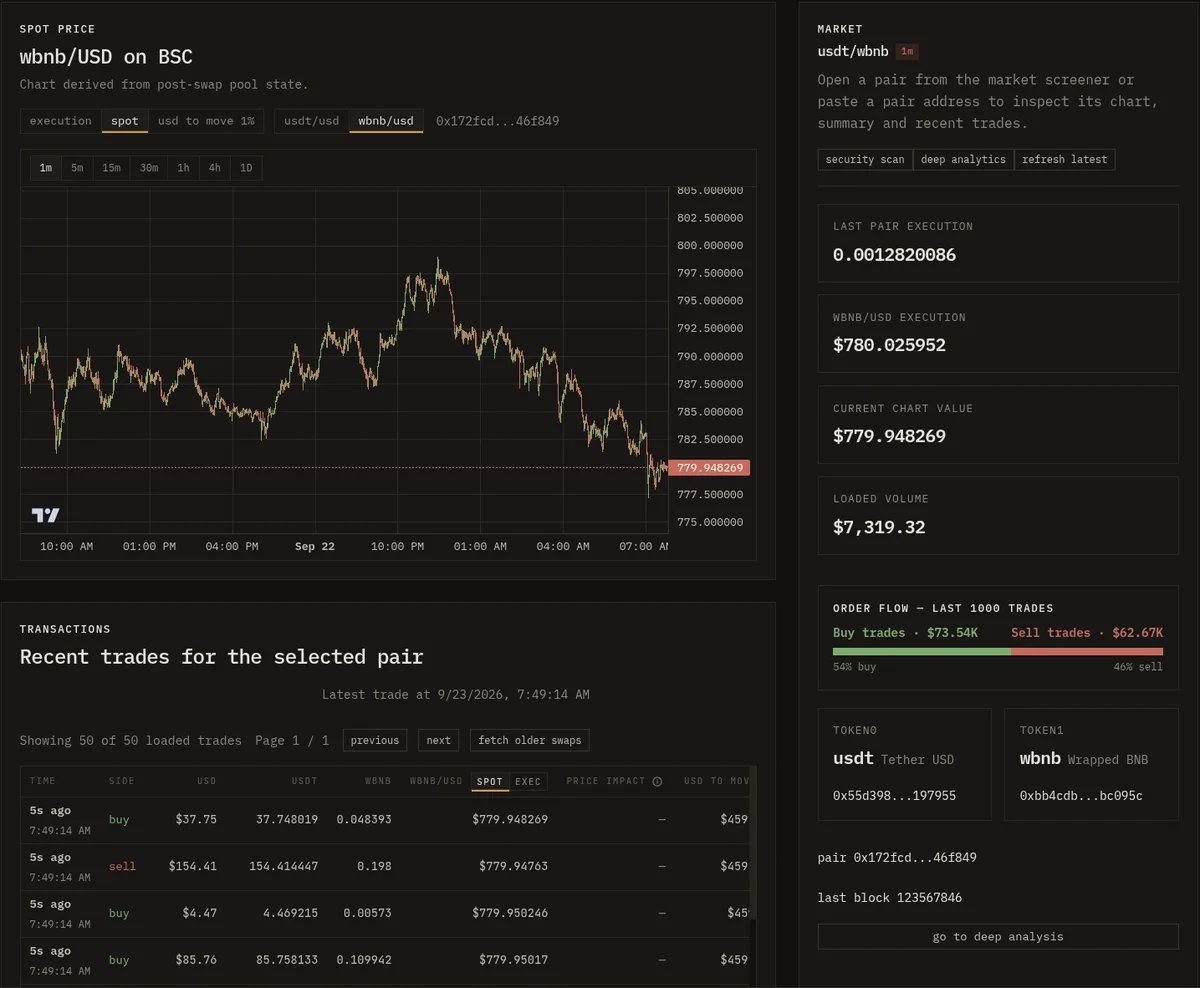
Página de un par de BSC: velas de un minuto a partir del estado del pool tras cada swap, los últimos trades según se indexan y el flujo de compras y ventas en los últimos 1.000 trades.
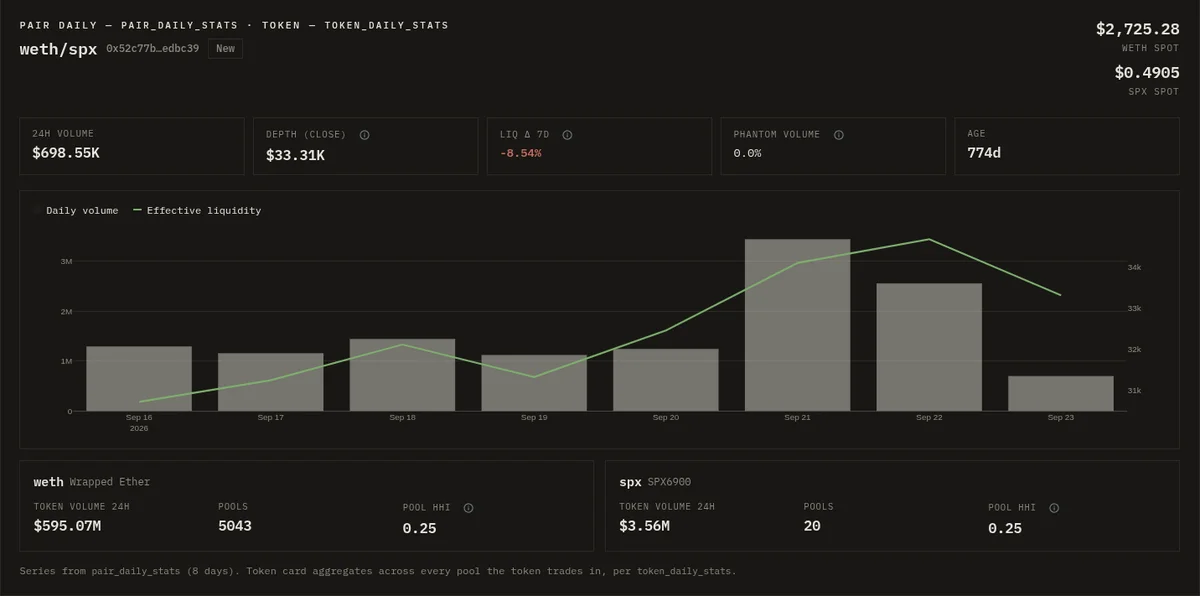
Estadísticas diarias por par y por token, agregadas a partir de los trades indexados: volumen, profundidad, cambio de liquidez y concentración de pools.
Mantener honesto el lado RPC
Los endpoints RPC públicos varían mucho. Algunos no guardan histórico antiguo, otros agotan el tiempo, otros
devuelven logs incompletos. El indexador hace failover entre proveedores, y los endpoints candidatos se comparan
con baselines, resultados conocidos para rangos de bloques fijos, antes de confiar en ellos.
El cálculo de precios es matemática en memoria sobre el estado de los pools. El RPC hace falta para logs,
metadatos de tokens y timestamps de bloques, y estos dos últimos se cachean en local. El tamaño de los lotes se
adapta a la densidad de logs: el optimizador apunta a unos 35.000 logs por lote y reduce cuando un proveedor
tiene problemas.
35.000 es un objetivo de tamaño de lote, no una cifra de rendimiento ni un límite fijo.
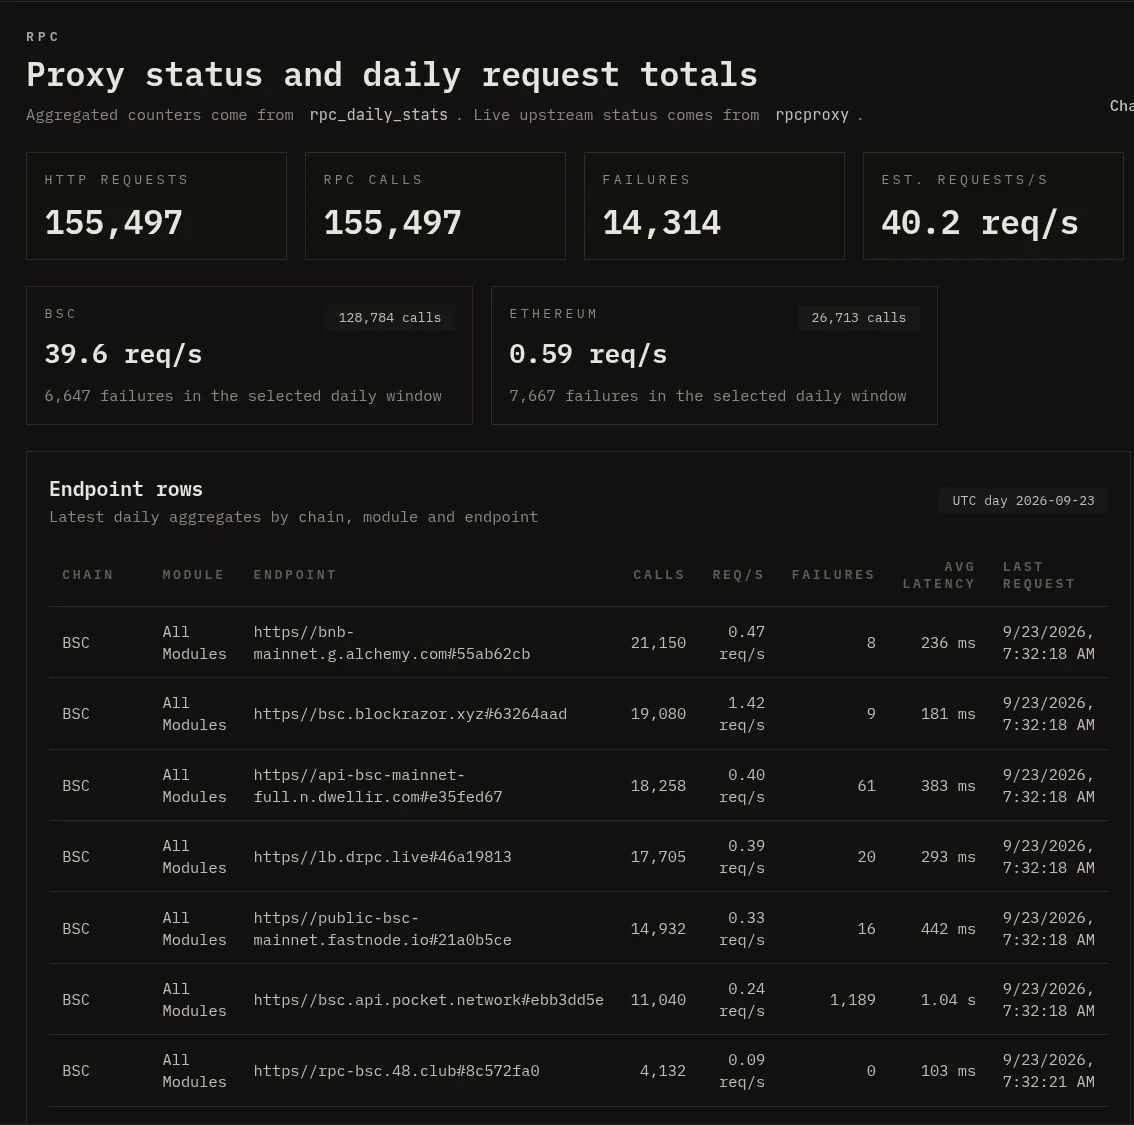
Un día UTC del proxy RPC: llamadas, fallos y latencia por endpoint de proveedor. Ese día falló cerca del 9% de las llamadas; para eso existen el failover y los baselines.
Lo que aún no he medido
Las cifras de arriba salen de mis propios logs. Para que otro ingeniero pueda reproducirlas, esto es lo siguiente:
logs por segundo sostenidos en esta placa, para una cadena y un rango de bloques fijos;
cuánto se retrasa el indexador en vivo respecto al último bloque;
latencia p95 de las consultas OHLCV;
tiempo de recuperación tras la caída de un proveedor RPC.
Llegarán a esta página, con el método, cuando los tenga.